Construindo meu blog, parte 1: escrever sem manter um backend
Como saí da referência do Akita para um blog em Hugo com identidade própria, conteúdo em arquivos e publicação estática.
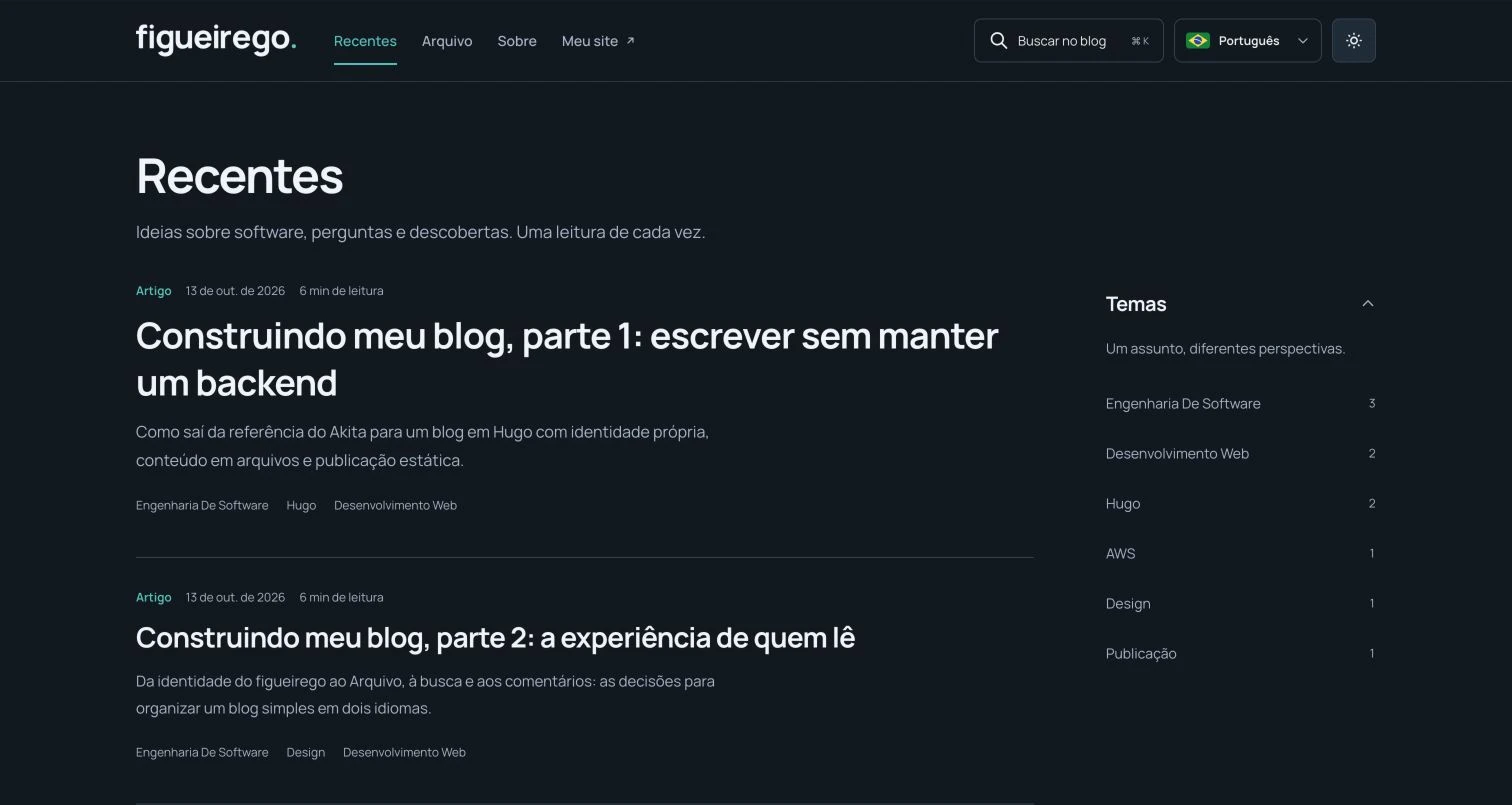
Este blog começa com arquivos de texto. O Hugo lê esses arquivos, aplica os layouts e gera as páginas que chegam ao navegador. Eu não preciso manter uma API de publicação nem um banco de dados próprio para servir os artigos.
Essa era a condição principal quando comecei: queria um lugar para explicar o que construo, registrar decisões e voltar a elas depois. Também queria que o espaço tivesse a identidade do figueirego, fosse confortável no celular e permitisse ler em português ou inglês.
Entre a primeira referência e a versão publicada, houve decisões sobre design, navegação, comentários, busca, hospedagem e imagens. Dividi o relato em três partes para explicar o conjunto sem misturar todas as responsabilidades:
- Arquitetura: por que escolhi essa base e o que cada componente faz.
- Experiência de leitura: organização, idiomas, busca, temas e comentários.
- Publicação e operação: do Markdown ao domínio público, incluindo imagens e estatísticas.
A referência foi o Akita; o resultado precisava ser meu
O ponto de partida foi Meu Novo Blog — Como Eu Fiz, do Fabio Akita. O que me interessou foi a escolha de publicar arquivos Markdown como um site estático e reduzir o trabalho de manter uma engine própria. A prioridade era conseguir escrever.
Eu gostei da proposta técnica, mas queria outra direção visual: as cores do meu site, a minha marca e uma organização pensada para os conteúdos que pretendo produzir. Separar essas duas decisões ajudou. Adotar Hugo não me obrigava a reproduzir a aparência de outro blog.
Também precisei corrigir uma confusão de nomes logo no começo: Hugo é o gerador; Hextra é o tema. O Hugo é escrito em Go. O Hextra fornece uma base de layouts e recursos sobre a qual o blog pode ser construído. O repositório do Hextra documenta essa relação.
O que acontece quando alguém abre um artigo
A página já está gerada quando o leitor chega. A hospedagem entrega HTML, CSS, JavaScript e os arquivos necessários. Não há uma consulta ao meu banco de dados para montar o texto a cada acesso.
O caminho principal é este:
Texto em Markdown + metadados + layouts
                    ↓
                   Hugo
                    ↓
             páginas estáticas
                    ↓
                Hostinger
                    ↓
             navegador do leitor
Isso não transforma o blog em uma página sem comportamento. A busca roda no navegador, os filtros respondem a cliques, o tema muda e os comentários vêm de um serviço externo. A distinção útil está no que preciso operar: o conteúdo principal não depende de um servidor de aplicação meu em execução.
Escolhi essa estrutura porque ela atende ao tipo de publicação que quero fazer. Não estou construindo uma plataforma com contas próprias de leitores, cobrança de assinaturas ou edição simultânea no navegador. Se essas necessidades aparecerem, merecerão uma decisão específica.
Uma função clara para cada ferramenta
A implementação ficou dividida assim:
| Componente | Responsabilidade neste blog |
|---|---|
| Markdown | Guardar os textos e seus metadados. |
| Hugo + Hextra | Gerar as páginas e fornecer a base visual e funcional. |
| Layouts, CSS e JavaScript próprios | Aplicar a identidade e os comportamentos específicos do figueirego. |
| GitHub privado | Versionar o código-fonte e executar as verificações e o build. |
| Hostinger | Servir o site estático no domínio público. |
| Amazon S3 | Guardar imagens enviadas separadamente do site. |
| Disqus | Hospedar a conversa e a moderação dos comentários. |
| GoatCounter | Registrar visitas usadas na geração dos mais lidos. |
Uma decisão importante foi aproveitar a hospedagem que eu já tinha. Cheguei a considerar outros destinos, mas o blog foi publicado na Hostinger. A AWS entrou para as imagens, não como hospedagem das páginas. Não há uma distribuição CloudFront fazendo parte deste fluxo.
Os arquivos-fonte permanecem em um repositório privado. O leitor recebe o resultado publicado; não precisa de acesso ao repositório. Isso também não torna secretos os arquivos que envio ao site: textos, imagens, HTML e JavaScript servidos ao navegador são públicos.
O tema é uma base que posso personalizar
Nesta primeira versão, fixei Hugo Extended 0.167.0 e Hextra 0.13.0. O tema está incluído no repositório. Para gerar este projeto com o binário instalado do Hugo, não preciso instalar Go ou executar um build npm local.
As personalizações ficam separadas da pasta do tema:
content/          textos em português e inglês
layouts/          páginas e componentes personalizados
assets/           estilos, busca e interações
static/           fontes, marca e imagens locais
i18n/             mensagens da interface
themes/hextra/    base do tema
scripts/          upload e verificações auxiliares
Essa separação deixa mais claro onde procurar um problema. Um texto incorreto vai para content/. Uma mensagem do botão em inglês vai para i18n/. Um espaçamento ou contraste vai para os estilos. Uma mudança no serviço de comentários fica na integração correspondente.
Atualizar o tema no futuro ainda exigirá revisão. Separar os arquivos torna o trabalho mais compreensível; não garante compatibilidade automática com qualquer versão nova.
Onde eu escrevo, afinal?
Essa foi uma das dúvidas durante a construção. Não existe uma aba administrativa dentro do blog em que eu entro e começo a digitar. A edição acontece no computador, em arquivos Markdown, usando um editor de texto ou de código.
Cada publicação tem um cabeçalho com título, data, resumo, temas e estado de rascunho. Depois vem o texto. O conteúdo continua editável sem abrir um serviço de edição específico, e o Git registra as alterações que eu decido salvar em commits.
Para revisar, uso a prévia local do Hugo. Ela mostra a página com o layout real e permite incluir rascunhos. Publicar é outra etapa: enviar o conteúdo revisado, gerar a versão de produção e conferir o domínio público. Os comandos completos estão na terceira parte.
O texto do Akita sobre Docker também entrou nessa investigação. Ali, Docker prepara um ambiente local para contribuir com o repositório. Rodar essa cópia não publica automaticamente no site dele; uma contribuição segue por pull request. No meu fluxo atual, uso o Hugo localmente, sem adicionar Docker como requisito.
Idiomas entraram na estrutura desde o começo
Eu queria inglês na raiz do domínio e português em /pt/. Isso virou organização de conteúdo: cada idioma tem seus arquivos, ligados por uma chave de tradução estável.
O relato do Akita sobre traduzir seu acervo foi outra referência. No meu caso, estou começando com pares de textos, em vez de migrar um arquivo histórico. O botão de idioma navega entre versões já preparadas; não chama um tradutor a cada clique.
Isso coloca a revisão no processo editorial. Título, explicações e exemplos precisam continuar fazendo sentido nos dois idiomas. A infraestrutura conecta os arquivos, mas não decide se a tradução está boa.
Construir com IA também exigiu conferir o resultado
Usei o Codex como apoio para transformar as decisões em código, revisar comportamentos e organizar esta série. Para mostrar o resultado, esta série usa capturas reais das telas, identificadas por contexto nas legendas. O processo teve prévias, capturas de tela, pedidos de ajuste e verificações do site servido.
Algumas correções nasceram do uso direto: o botão de busca que não abria como esperado, os comentários que apareciam separados por idioma e o espaço excessivo no rodapé. Nenhuma delas seria resolvida apenas por escolher uma tecnologia adequada.
A construção chegou a incluir propostas de newsletter e novas divisões no menu. A newsletter saiu por enquanto; os formatos ficaram dentro do Arquivo. Ter uma possibilidade na implementação não significava que ela precisava entrar na primeira versão.
O próximo passo já é usar essa estrutura para escrever. Para entender como ela se apresenta a quem chega ao blog, siga para a parte 2: experiência de leitura.
Série Construindo meu blog: 1. Arquitetura · 2. Experiência de leitura · 3. Publicação e operação.
Comentários
A conversa continua no Disqus.
O tema do blog mudou. Envie ou copie qualquer rascunho antes de atualizar os comentários.