Construindo meu blog, parte 3: do Markdown à publicação
Meu fluxo para escrever, traduzir, publicar na Hostinger, enviar imagens ao S3 e atualizar os mais lidos sem manter um backend próprio.
Nota editorial: Esta série registra a construção inicial do blog em Hugo, separado do portfólio. A versão unificada do site reúne os dois em figueirego.com, com o blog em
/blog/(inglês) e/pt/blog/(português). Os comandos, as capturas e o fluxomain→published→blog.figueirego.comabaixo pertencem à versão independente; não descrevem a publicação do site unificado.
O arquivo que contém este texto está em content/pt/posts/. A versão em inglês fica em content/en/posts/. Para publicar, eu reviso os dois, gero o site, verifico o resultado e envio a alteração ao GitHub. A hospedagem recebe páginas prontas.
Era essa a experiência que eu procurava: conseguir escrever sem precisar cuidar de uma aplicação de publicação funcionando o tempo inteiro. Ainda há ferramentas e serviços envolvidos. A diferença está em saber qual trabalho cada um faz e em manter um caminho curto entre o texto e o leitor.
Esta é a terceira parte da construção do blog. Na primeira, expliquei a arquitetura; na segunda, as decisões de leitura e navegação. Aqui vou percorrer a publicação de ponta a ponta.
O editor é um arquivo no computador
Escrevo em Markdown, no editor de código. Para começar um artigo, uso o modelo que já está no repositório:
hugo new content content/pt/posts/meu-artigo.md --kind default
hugo new content content/en/posts/my-article.md --kind default
Os arquivos nascem como rascunhos. O cabeçalho do texto, chamado front matter, reúne os dados que o layout precisa. Um exemplo reduzido, seguindo as convenções deste projeto:
---
title: "Como publiquei meu blog"
date: 2026-10-13T09:00:00-03:00
draft: true
sample: false
author: "Matheus Figueirêdo"
translationKey: "how-i-published-my-blog"
description: "Da escrita em Markdown à publicação."
summary: "As decisões e o fluxo para colocar o blog no ar."
tags: ["engenharia de software", "Hugo"]
image: "/images/minha-capa.webp"
imageAlt: "Tela do Arquivo do blog, com publicações organizadas por ano."
imageCaption: "Captura da prévia local do Arquivo."
imageWidth: 1512
imageHeight: 805
---
Na tradução, título, resumo e texto mudam. A translationKey permanece igual, mesmo que os nomes dos arquivos sejam diferentes. É assim que relaciono as duas versões. O seletor de idioma encontra a tradução existente; ele não traduz o artigo sozinho. Esse uso da chave segue o front matter do Hugo.
As dimensões precisam corresponder à imagem real. A capa é opcional: uma nota curta pode funcionar melhor só com texto. Para inserir uma imagem no meio de um artigo, uso a sintaxe habitual:
Salvar, visualizar e publicar são etapas diferentes
Durante a escrita, inicio a prévia:
hugo server --buildDrafts --bind 127.0.0.1O endereço local permite revisar o texto, as imagens e os dois idiomas. --buildDrafts inclui os rascunhos nessa visualização. Salvar o arquivo atualiza a prévia; nada disso coloca o artigo na internet.
Na versão independente, antes de publicar, eu alterava draft para false e verificava o resultado com esta configuração de produção:
python3 -m unittest discover -s tests -v

hugo --config hugo.yaml,hugo.production.yaml \
  --environment production --minify --panicOnWarning \
  --cleanDestinationDir \
  --baseURL https://blog.figueirego.com/

python3 scripts/check-site.py public \
  --production-url https://blog.figueirego.com/
Os testes cobrem comportamentos do projeto; o verificador inspeciona o HTML gerado, links locais, traduções, feeds e metadados de publicação. A configuração de produção também retira as restrições de indexação usadas na prévia. Gerar apenas a versão local e copiar seus arquivos poderia levar essas restrições para o site público.
Testes não substituem leitura. Também preciso conferir se a capa combina com o texto, se a tradução está natural e se os exemplos fazem sentido.
GitHub entrega; Hostinger serve as páginas
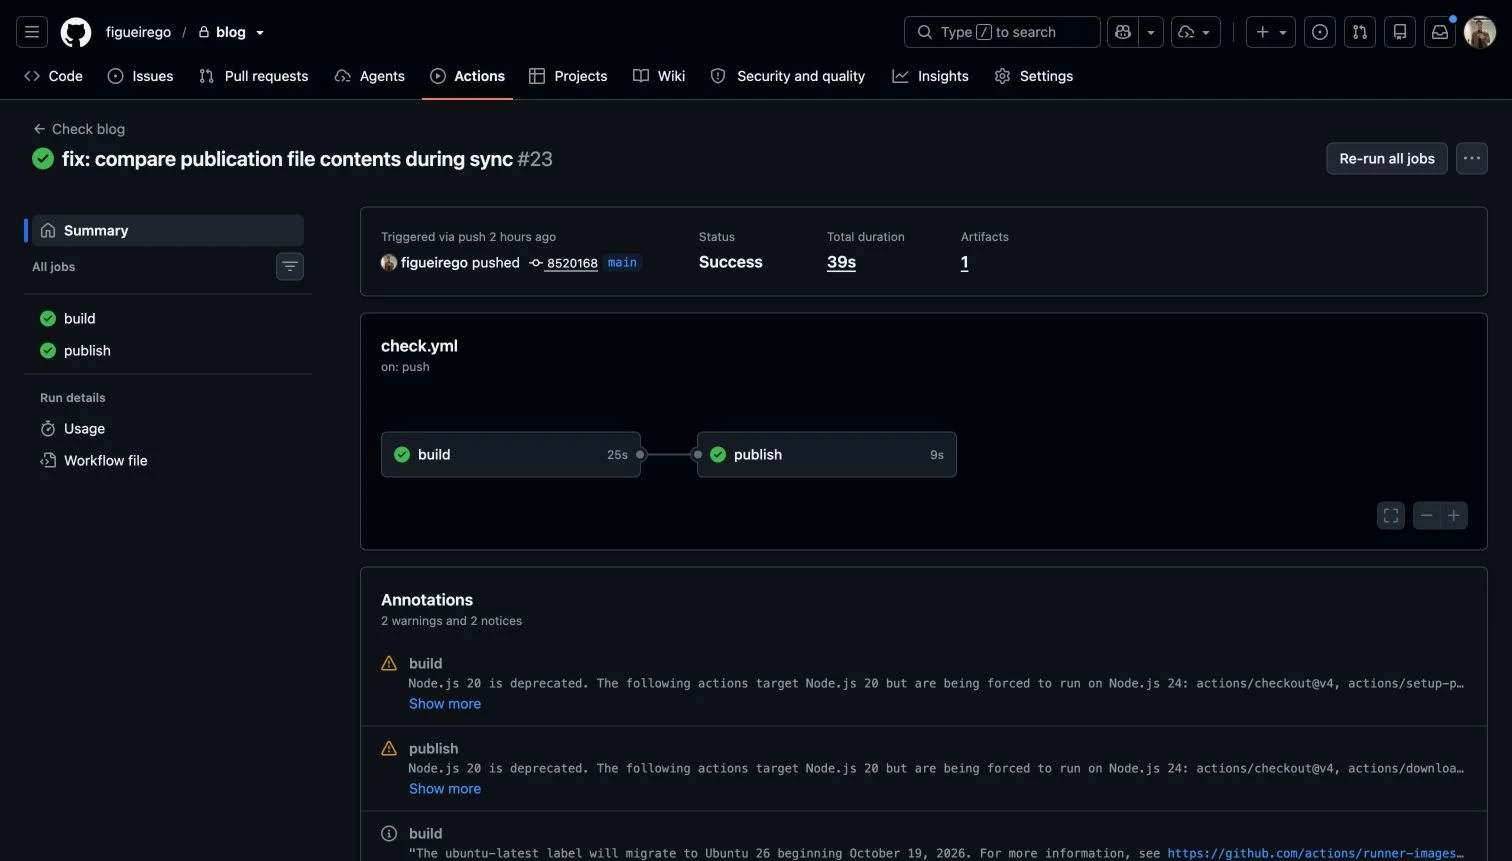
Naquela versão, depois da revisão, eu enviava para a main os arquivos de conteúdo e as imagens locais necessárias. O workflow repetia os testes, fazia o build do Hugo e preparava a branch published com o resultado.
O percurso de publicação do blog independente ficou assim:
Markdown e imagens locais
        ↓
GitHub: main
        ↓
testes + Hugo + verificação dos arquivos
        ↓
GitHub: published
        ↓
Hostinger → blog.figueirego.com
O código-fonte fica separado do pacote servido. Não edito published manualmente, porque seu conteúdo é gerado pelo workflow.
Existe um package.json mínimo nessa branch para compatibilidade com o preset da Hostinger. Ele não tem dependências e seu comando de build apenas verifica a existência de public/index.html. O Hugo já executou no GitHub; a hospedagem recebe HTML, CSS, JavaScript e assets prontos. Não preciso manter um servidor de aplicação ou banco de dados próprio para entregar os artigos.
Uma publicação só está confirmada depois de conferir três coisas: os checks no GitHub, o deployment correspondente na Hostinger e a página no domínio público. Um workflow verde comprova aquela execução; não comprova, sozinho, qual versão o leitor recebeu.
As imagens podem seguir junto ou ficar no S3
A AWS entrou como armazenamento de imagens. As páginas continuam na Hostinger. Um arquivo em static/images/ acompanha o build; uma imagem no S3 é enviada separadamente e referenciada por sua URL pública.
Não preciso migrar toda imagem para a AWS para usar o blog. Posso publicar uma capa local junto do artigo e usar o S3 quando quiser manter um arquivo fora do pacote do site. O build não faz uploads automaticamente.
Para o envio, configurei um usuário IAM dedicado, com permissões limitadas ao prefixo de imagens do bucket. Ele usa MFA por passkey e login temporário da AWS CLI, sem uma chave de acesso permanente dentro do projeto. A AWS documenta esse fluxo de autenticação pelo navegador.
O script de upload permite conferir o destino antes de enviar. Os nomes abaixo são exemplos; devem ser substituídos pelos valores de um ambiente já configurado:
aws login --profile meu-blog --region us-east-1

python3 scripts/upload-image.py /caminho/capa.webp \
  --bucket meu-bucket-de-imagens \
  --base-url https://meu-bucket-de-imagens.s3.us-east-1.amazonaws.com \
  --profile meu-blog \
  --prefix images \
  --dry-run
O --dry-run valida o arquivo e mostra um destino possível, mas não envia nada nem confirma acesso público. Para enviar, repito o comando do script sem essa opção. Cada execução gera uma chave nova; a URL da simulação não será a URL final.
Depois do envio, abro a URL retornada sem sessão AWS e verifico a imagem. O script não torna um bucket privado público: a permissão de leitura já precisa estar configurada. No meu fluxo, as imagens publicadas usam HTTPS sem assinatura temporária, para que o endereço não expire junto de uma sessão.
O upload define cache longo com immutable e nomes únicos. Se eu corrigir uma imagem, envio outro arquivo e atualizo a URL no texto. A versão anterior permanece no bucket até ser removida. Também há um alerta de custos: ele avisa sobre o gasto, mas não impõe um teto nem desliga recursos. Blog simples não é promessa de conta zerada.
“Mais lidos” sem consultar estatísticas a cada leitura
O GoatCounter registra as visitas, e o GitHub consulta essas estatísticas durante a publicação e em uma execução diária agendada. O resultado vira uma lista estática incorporada à página inicial.
O token tem permissão de leitura das estatísticas e fica em um secret do GitHub, disponível à etapa responsável por essa consulta. Ele não vai para o JavaScript do leitor. No navegador, há o script público de contagem; a montagem do ranking acontece antes de servir a página. A autenticação da integração segue a API do GoatCounter.
Os filtros têm significados precisos:
- Semana: os sete dias completos anteriores à atualização, em UTC.
- Mês: os trinta dias completos anteriores à atualização, em UTC.
São janelas móveis, não a semana e o mês do calendário. O dia atual fica de fora por estar incompleto. A lista é atualizada diariamente, sem promessa de tempo real.
As visitas às versões em português e inglês são somadas pela translationKey; o link e o título aparecem no idioma do leitor. O número representa visitas registradas, não uma garantia de leitura completa ou de pessoas únicas entre idiomas. Bloqueadores também podem impedir a coleta.
Se uma consulta falhar, preservo o último resultado válido daquele período, com a data original. Se não houver dados válidos, não invento números: a lista fica vazia, e a seção permanece oculta quando nenhum período tem conteúdo.
A rotina depois de colocar no ar
Comentários ficam no Disqus e precisam de moderação. RSS acompanha as publicações elegíveis de cada idioma e oferece uma forma de seguir o blog. A newsletter ficou de fora por enquanto.
Terceirizar essas funções reduz o que eu opero, mas mantém dependências: hospedagem, armazenamento, comentários e estatísticas podem falhar ou mudar suas condições. O texto e sua publicação continuam apoiados nos arquivos versionados.
Para o próximo artigo, minha rotina é concreta: escrever, revisar a tradução, preparar a capa, conferir a prévia, rodar as verificações, enviar a alteração e abrir a página publicada. Depois, responder aos comentários e corrigir o que precisar. A infraestrutura tem de deixar espaço para esse trabalho.
Nesta série: 1. Arquitetura · 2. Leitura e navegação · 3. Publicação.
Comentários
A conversa continua no Disqus.
O tema do blog mudou. Envie ou copie qualquer rascunho antes de atualizar os comentários.